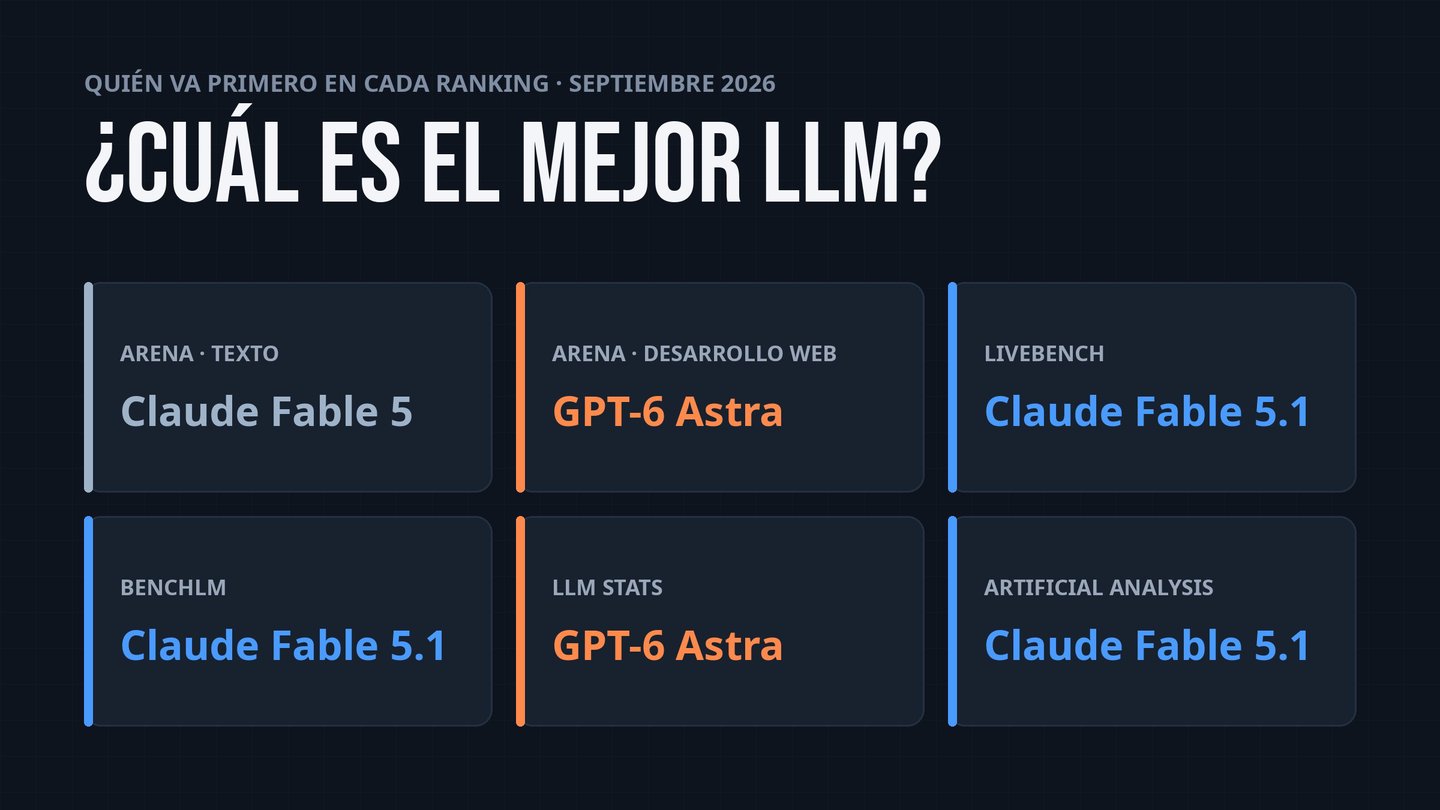
Pasan unas semanas y aparece una IA que «supera a todos», aunque el resultado varía según la tabla que se consulte. Pongamos como ejemplo el 14 de septiembre de 2026: Claude Fable 5.1 manda en Artificial Analysis, LiveBench y BenchLM; GPT-6 Astra se coloca primero en LLM Stats y en el apartado de desarrollo web de Arena; y en texto general de Arena sigue arriba el modelo previo, Claude Fable 5. Los datos no fallan: cada sistema evalúa facetas diferentes.
Conviene aclarar esto antes de creer una tabla:
- Existen tres maneras de evaluar un LLM (el modelo de lenguaje que hay detrás de ChatGPT, Claude o Gemini): pruebas con respuestas autocorregidas, caso de LiveBench; votos de personas que enfrentan dos contestaciones sin conocer su origen, como Arena; y agregadores que condensan cientos de ensayos en una nota, como BenchLM, LLM Stats o Artificial Analysis.
- En la cabeza, las distancias suelen ser empates. Los diez mejores de texto en Arena quedan a 13 puntos, con márgenes de error de hasta ±11; en BenchLM, primero y segundo quedan a medio punto.
- Popularidad no equivale a calidad. OpenRouter enseña cuáles se emplean más mediante su servicio, y en esa lista vencen los económicos.
- Tu propia prueba continúa siendo la decisiva: echa mano de los rankings para filtrar dos o tres aspirantes y pruébalos con preguntas tuyas.
| Web | Cómo mide | Lo mejor | Lo peor |
| Arena | Votos a ciegas entre dos respuestas | Millones de votos y márgenes de error visibles | Premia el estilo y la preferencia, no el acierto |
| LiveBench | Preguntas nuevas corregidas automáticamente | Difícil de «hacer trampa» memorizando | Tandas cada varios meses y pocos modelos |
| BenchLM | Agrega 435 pruebas en una nota | Separa lo medido de lo estimado | Nota compuesta difícil de auditar |
| LLM Stats | Agrega pruebas públicas, precio y velocidad | Más de 300 modelos con precio y velocidad | Textos desfasados y modelos que no se pueden usar |
| Artificial Analysis | Pasa las pruebas por su cuenta | Mismas condiciones para todos y coste por tarea | El índice cambia de versión a menudo |
| OpenRouter | Uso real a través de su API | Dice qué se usa de verdad | No mide calidad |
| Epoch AI | Índice de capacidad a largo plazo | Compara modelos de años distintos | Sirve para ver la evolución, no para elegir modelo hoy |
Tres formas de medir un modelo, y por qué no coinciden
Casi todas las clasificaciones de IA se basan en una de estas tres ideas, o en varias de ellas. Saber cuál utiliza cada web explica la mayoría de las contradicciones.
Exámenes que se corrigen solos
Hablamos de los benchmarks clásicos: un conjunto de ejercicios de lógica, matemáticas, programación o comprensión en los que cada uno tiene una solución válida que se verifica automáticamente. Su principal ventaja es que no intervienen opiniones. Sin embargo, presentan dos fallos conocidos:
- La contaminación. Cuando los enunciados circulan por internet, terminan en el corpus de entrenamiento del modelo siguiente, que los «recuerda» en lugar de resolverlas.
- La saturación. Cuando todos los modelos punteros sacan un 95 %, el test ya no los diferencia. De ahí que las webs retiren exámenes y estrenen otros cada pocos meses.
Hay un matiz adicional: el fabricante publica muchas cifras al lanzar su modelo y elige los tests y ajustes que mejor lo dejan.
Votos de personas
Otra alternativa es recurrir a la opinión del público. Un usuario plantea una duda, recibe dos respuestas de modelos anónimos y elige la que más le gusta. Gracias a millones de votos, es posible calcular una puntuación similar a la del ajedrez: ganar a un rival potente aporta más que derrotar a uno débil.
Este método capta algo que los exámenes no detectan: hasta qué punto una contestación resulta útil y amena para alguien de carne y hueso. Como contrapartida, un texto extenso, bien presentado y con tono seguro suele llevarse votos aunque esconda un fallo que quien vota no advierte.
Agregadores
Los agregadores recopilan resultados de decenas o cientos de ensayos y, en ocasiones, también votos, tarifas y rapidez, para fusionarlos en una nota única. Es la manera más rápida de hacerse una idea, aunque esa cifra depende de qué ensayos entran, cuánto vale cada uno y cómo se resuelve la ausencia de datos en un modelo. Dos de estas webs pueden ordenar la cabeza de forma distinta aunque utilicen datos idénticos.
Arena (antes LMArena): el ranking de los votos
Arena es el ranking de IA más citado. Surgió en 2023 como Chatbot Arena, creado por investigadores de la Universidad de California, campus de Berkeley. Posteriormente pasó a llamarse LMArena y el 28 de enero de 2026 quedó rebautizada como Arena, momento en el que estrenó el dominio arena.ai. Actualmente es una empresa que asegura superar los 5 millones de usuarios mensuales y su dirección anterior, lmarena.ai, redirige a la nueva.
Su funcionamiento es sencillo: planteas una duda, dos modelos anónimos responden y eliges la contestación que más te convence. Los nombres se revelan después. Esos votos sirven para clasificar los modelos en diversas tablas de texto, programación web, visión, documentos, imagen, vídeo, búsqueda y agentes.
El 13 de septiembre de 2026, su tabla de texto contaba con 8.146.274 votos y 402 modelos. También incluye 29 categorías, entre las que están programación, matemáticas, escritura creativa y español.
Lo mejor
- Mide a personas usando la IA de verdad, con dudas auténticas y no un cuestionario fijo susceptible de memorizarse.
- Muestra la incertidumbre. Todo modelo incluye un margen de error y un «rango de puesto» que revela en qué lugares podría encontrarse de verdad.
- Corrige el estilo por defecto. Introduce un correctivo para que una contestación no triunfe únicamente por su extensión o por lucir más negritas.
- Distingue por tareas. Un mismo modelo puede quedar 24.º en texto y 1.º en desarrollo web, tal como le ocurre a GPT-6 Astra.
- No cuesta nada y permite experimentar. Ofrece un modo para enfrentar dos modelos que elijas tú con preguntas de tu cosecha.
Lo peor
- Que algo guste no lo hace cierto. Quien consulta un tema que desconoce no distingue si la contestación acierta, solo si le resulta atractiva.
- En la cima, casi siempre hay empates. Dentro de la clasificación de texto, del 1.º al 10.º median 13 puntos, y quien va 8.º quizá esté en cualquier puesto del 1.º al 24.º.
- Las categorías con pocos datos inspiran poca confianza. La de español reúne 160.421 votos, un 2 % del total, y su cuarto puesto quizá caiga en cualquier lugar del 1.º al 44.º.
- A los recién llegados les cuesta asentarse. Con pocos miles de votos, su nota aún puede oscilar bastante y algunos salen etiquetados como preliminares.
- No se ha librado de la polémica. En abril de 2025, el trabajo The Leaderboard Illusion reveló que ciertas compañías grandes probaban en privado numerosas variantes antes de estrenar un modelo y solo enseñaban la mejor. Meta probó 27 antes de Llama 4. Ese mismo estudio estimó que Google y OpenAI se habían llevado cerca del 20 % de los datos cada una, mientras 83 modelos abiertos sumaban el 29,7 %.
- Lo que preguntas deja de ser privado. Arena advierte de que almacena tus mensajes para evaluarlos y cede parte de los votos a los fabricantes. No conviene pegar ahí datos personales ni laborales.
LiveBench: el examen que se renueva
LiveBench nació en 2024 gracias a científicos de Abacus.AI, NVIDIA, la Universidad de Nueva York y otros centros, entre los que se encuentra Yann LeCun. Su financiación proviene de Abacus.AI. Para evitar la contaminación, sus preguntas proceden de fuentes recientes (noticias, trabajos científicos o competiciones matemáticas) y se actualizan periódicamente, así ningún modelo las haya visto durante su entrenamiento.
Cada respuesta tiene una solución objetiva y se corrige de forma automática, sin que un modelo de IA actúe como juez. Los tests se dividen en siete apartados: análisis de datos, lenguaje, matemáticas, razonamiento, seguimiento de instrucciones, programación y programación con agentes. La nota global se obtiene mediante la media de esos siete bloques.
Lo mejor
- Es el modo más limpio de medir capacidad pura. Cuando un modelo acierta, ha resuelto el ejercicio; no se limita a resultar convincente.
- Aguanta la memorización, pues los enunciados nuevos no circulaban cuando se entrenó cada modelo.
- Es abierto. Tanto el código como los enunciados de ediciones previas están publicados, de modo que cualquiera puede reproducir los tests.
- Permite comparar por categorías, práctico si únicamente te interesa, por ejemplo, programar o analizar datos.
Lo peor
- Se renueva menos de lo prometido. Arrancó anunciando enunciados nuevos cada mes, aunque la tanda actual data del 25 de junio de 2026 y la previa, del 8 de enero. Tampoco apareció ninguna entre mayo y noviembre de 2025.
- Evalúa a pocos modelos. Su tanda más reciente incluye 57, lejos de los cientos de Arena o de los agregadores. Si falta el que te interesa, no habrá dato.
- No valora la legibilidad. Un resultado certero pero enrevesado obtiene los mismos puntos que uno diáfano.
- Su patrocinador también participa. Abacus.AI somete allí a examen sus modelos Smaug. El más destacado, una variante afinada de Kimi K3, supera al original, 79,5 frente a 79,2, aunque queda lejos del podio.
BenchLM: el agregador que admite lo que no sabe
BenchLM agrupa en una sola tabla el tamaño de contexto, la velocidad, los precios y los resultados de diversos tests. A 10 de septiembre de 2026, monitorizaba 435 pruebas y 489 modelos, los cuales organiza mediante BenchAlign, una puntuación propia que integra los datos de las pruebas, el voto humano y los índices de terceros.
Lo más destacable es cómo gestiona la falta de datos. En vez de asignar un cero o basarse solo en los resultados que el desarrollador ha decidido hacer públicos, estima el rendimiento con la información disponible y lo indica. Esto crea dos categorías: Supported, si hay suficientes pruebas independientes, y Estimated, si la puntuación es un cálculo con un margen de error superior. De los modelos evaluados, 130 pertenecen al primer grupo y 102 al segundo.
Lo mejor
- Aclara cuánto se conoce de cada modelo. Aparte de la etiqueta, toda nota incluye un intervalo: el primero, Claude Fable 5.1, suma 84,61 puntos, aunque su valor real quedaría entre 78,2 y 91,0.
- No mezcla lo incomparable. Ajusta cada ensayo antes de sumarlo, en lugar de promediar porcentajes de exámenes con dificultad distinta.
- Ofrece listas según el uso: programación, agentes, contexto extenso, documentos, ciberseguridad, modelos abiertos, chinos y europeos…
- Aporta respuestas útiles, como cuál es el mejor modelo abierto o el que casi iguala la nota del primero gastando menos.
- Los datos admiten descarga en CSV y JSON.
Lo peor
- La nota final es difícil de auditar. De las 435 pruebas, únicamente una parte influye en ella. En programación, por ejemplo, pesan 7 y otras 58 aparecen solo a título orientativo.
- La cabeza se solapa. Con horquillas de más de 10 puntos, el orden de los tres primeros (84,61, 84,08 y 81,97) apenas importa. Además, el segundo, GPT-6 Astra, lleva una nota estimada.
- Una única persona lo sostiene, según reconoce su página, y el sitio incluye publicidad y enlaces de afiliado. Afirma que estos no alteran las notas.
- Apunta a empresas y desarrolladores. Abundante jerga, tarifas de la API por millón de tokens y escasa guía para quien únicamente busca qué chat utilizar.
LLM Stats: mucho catálogo, con letra pequeña
LLM Stats se define como un «centro de benchmarks de IA». En su tabla principal incluye 390 modelos, ordenados según el LLM Stats Score, una puntuación basada en pruebas públicas que se complementa con datos sobre razonamiento, programación, agentes, ventana de contexto, rapidez, coste y licencia. También ofrece listas de modelos abiertos, generación de imagen y vídeo, voz y una sección dedicada a arenas de votos.
Según su metodología, los resultados no verificados aparecen señalados y quedan fuera de la nota, mientras que los precios se cotejan con facturas reales.
Lo mejor
- Es el catálogo más extenso en una sola vista, con coste, rapidez y licencia junto a las notas.
- Filtra según lo relevante: únicamente modelos abiertos, los últimos 30 o 90 días, precio o tamaño.
- Distingue lo comprobado de lo que no. Los datos sin confirmar quedan visibles, aunque no elevan la nota.
- Incluye páginas por tipo de modelo: imagen, vídeo, voz a texto, texto a voz y embeddings, terrenos que otras clasificaciones ignoran.
Lo peor
- Cuela en la tabla modelos que no se pueden usar. El cuarto lugar lo ocupa Claude Mythos Preview, señalado como no lanzado.
- Arrastra textos anticuados. Su apartado de preguntas frecuentes sigue citando como referencias de 2026 DeepSeek V3 y R1, Grok 4 o Gemini 3 Pro, varias generaciones por detrás de la tabla vecina.
- La metodología queda en resumen. Aclara el origen de los datos, pero omite cuánto aporta cada prueba a la nota y remite al contacto para ampliar.
- Comercializa servicios entre los evaluados. Vende pruebas a medida, etiquetado de datos y una API con su información, práctica común del sector que conviene conocer.
- Exige probar que eres humano antes de navegar, un fastidio si buscas un dato.
Otros rankings que conviene conocer
No todo se limita a esos cuatro. Los tres siguientes cubren huecos que otros descuidan.
Artificial Analysis: las pruebas, hechas por su cuenta
En lugar de limitarse a recopilar datos, Artificial Analysis realiza sus propios tests en condiciones idénticas para cada modelo. Su Intelligence Index (actualmente en la versión 4.3) se compone de diez evaluaciones distintas, entre las que se incluyen Humanity’s Last Exam, SciCode y Terminal-Bench. Esta herramienta también analiza la velocidad real según el proveedor y el coste de ejecutar cada tarea del índice. El sitio web incluye 650 modelos y sirve de base para otras clasificaciones, como BenchLM.
- Lo mejor: no depende de lo que anuncie el fabricante, y el gasto por tarea revela modelos económicos por token que resultan caros porque «piensan» demasiado.
- Lo peor: el índice estrena versión a menudo. La 4.3 reemplazó un test y modificó otro, de manera que una nota de hace meses no resulta comparable con la actual. Además, prioriza trabajo, programación y ciencia, y no valora la escritura de un modelo ni el agrado de sus respuestas.
OpenRouter: lo que se usa de verdad
OpenRouter permite acceder a cientos de modelos a través de una única API y publica cuáles son los que mueven más tokens en su plataforma. El 13 de septiembre de 2026, los primeros eran GPT-5.6 Luna, Hy4 preview de Tencent y GLM 5.3 Flash. Ninguno de estos tres modelos encabeza las listas de calidad.
- Lo mejor: mide lo que prefieren los programadores al pagar de su bolsillo, con desgloses por programación, idiomas o llamadas a herramientas. Sus datos son abiertos, bajo licencia CC BY 4.0.
- Lo peor: la propia OpenRouter advierte de que mide adopción, no calidad. Únicamente contabiliza el tráfico que atraviesa su servicio, las versiones gratuitas van aparte y un modelo que escribe mucho mueve más tokens sin que ello implique que guste más.
Epoch AI: la evolución a largo plazo
Epoch AI investiga el progreso de la IA. Su Epoch Capabilities Index convierte los resultados de múltiples tests en una escala de capacidad común, lo que resulta útil para comparar modelos de diferentes años aunque los exámenes antiguos estén saturados. Este índice cuenta con variantes para ciberseguridad, matemáticas y programación.
- Lo mejor: sirve de referencia para medir cuánto progresan los modelos y a qué velocidad, sin el ruido del estreno semanal.
- Lo peor: no está pensado para decidir qué modelo usar hoy, y omite precio y velocidad.
Quién va primero en cada ranking, septiembre de 2026
Así estaban las clasificaciones a mediados de septiembre de 2026. El panorama cambiará con el próximo lanzamiento, aunque esto ilustra cómo una misma pregunta recibe respuestas diferentes:
| Ranking | Primero | Segundo | Qué hay que saber |
| Arena, texto (13 sept.) | Claude Fable 5 (1.506) | Claude Opus 4.6 high (1.505) | GPT-6 Astra va 24.º, con solo 2.693 votos |
| Arena, desarrollo web (13 sept.) | GPT-6 Astra (1.800) | Claude Fable 5.1 (1.758) | La clasificación con más distancia entre modelos |
| LiveBench (tanda del 25 jun.) | Claude Fable 5.1 (83,4) | Claude Fable 5 (83,0) | GPT-6 Astra, tercero con 82,2 |
| BenchLM (10 sept.) | Claude Fable 5.1 (84,61) | GPT-6 Astra (84,08) | La nota de GPT-6 Astra está marcada como estimada |
| LLM Stats (14 sept.) | GPT-6 Astra (59,9) | Claude Fable 5.1 (55,9) | La mayor distancia entre los dos |
| Artificial Analysis (índice 4.3) | Claude Fable 5.1 (53,4) | GPT-6 Astra (52,8) | Tercero, Claude Opus 5 (50,7) |
| OpenRouter, uso (13 sept.) | GPT-5.6 Luna | Hy4 preview (Tencent) | Mide tokens procesados, no calidad |
Cómo leer esta tabla
- Claude Fable 5.1 y GPT-6 Astra empatan técnicamente en la cima. Cuatro de las seis listas de calidad los sitúan entre los dos primeros. BenchLM y Artificial Analysis los separan por menos de un punto, y únicamente se distancian en LLM Stats y en el apartado de desarrollo web de Arena.
- Ver a GPT-6 Astra 24.º en el texto de Arena no implica que lo superen 23 modelos. Acumula muy pocos votos, su margen de error es de ±12 puntos y su lugar verdadero podría caer en cualquier puesto del 5.º al 51.º. Necesita tiempo para asentarse.
- Tampoco sorprende que venza un modelo veterano en votos. Claude Fable 5 y Claude Opus 4.6 reúnen decenas de miles de votos cada uno y mantienen una nota firme, mientras la de los novatos aún oscila.
- El más usado no aparece en ningún podio de calidad. GPT-5.6 Luna manda en OpenRouter y no figura arriba en ninguna lista de calidad: la adopción también depende del precio y la rapidez.
Cómo usar los rankings para elegir modelo
Ninguna clasificación responde por sí sola a «cuál es el mejor LLM». Si se usan en conjunto, sí ayudan a acertar. He aquí un método que funciona:
- Parte de la tarea, no de la tabla general. Si tu meta es programar, atiende a las listas de programación; si piensas escribir en español, a la categoría de español de Arena. Un modelo puede liderar el global y quedar décimo en tu terreno.
- Combina un examen con una lista de votos. Por ejemplo, LiveBench o Artificial Analysis junto a Arena. Que un modelo destaque en ambos resulta buena señal: resuelve y, encima, convence al público.
- Toma las distancias cortas como empates. Cuando los márgenes de error se cruzan o median menos de un par de puntos, ambos candidatos te sirven igual.
- Atiende a fecha y votos. Un modelo con pocos días o pocos miles de votos aún no tiene nota firme.
- Coloca el precio junto a la nota. Si pagas por consumo, el gasto por tarea de Artificial Analysis o la tarifa en BenchLM y LLM Stats pueden convertir al tercero en mejor compra que el primero. Con un chat de suscripción, importa qué modelo entra en tu plan.
- Somete a los dos o tres finalistas a tus preguntas. El modo comparativo de Arena no cuesta nada y permite enfrentar dos modelos simultáneamente. Emplea dudas reales de tu trabajo, sin datos personales ni confidenciales.
Qué no hacer
- Creer una única cifra del fabricante. Las notas de un estreno se escogen para lucir. Aguarda a que fuentes independientes las repitan, cosa que suele tardar unos días.
- Mudar de modelo con cada titular. Una subida de dos puntos en un agregador no se percibe en el día a día.
- Tomar el modelo por la aplicación. Las listas evalúan modelos concretos, a menudo con el máximo razonamiento. La versión gratis de un chat puede emplear otro modelo, o el mismo con menor esfuerzo.
Si buscas modelos para ejecutar en tu propio ordenador, el reto es distinto: además de la calidad, debes tener en cuenta qué cabe en tu memoria. Para ello existe LLMFit, una herramienta que determina qué modelos locales es capaz de ejecutar tu PC. Y si prefieres empezar sin pagar, en las mejores herramientas de IA gratis se encuentran los chats con plan gratuito.
Preguntas frecuentes
¿Cuál es el mejor LLM ahora mismo?
Hacia mediados de septiembre de 2026, Claude Fable 5.1 y GPT-6 Astra ocupan la cabeza en casi todas las listas de calidad, con distancias que entran dentro del margen de error. Tu elección depende de la tarea: GPT-6 Astra brilla en el desarrollo web de Arena, mientras Claude Fable 5.1 manda en las notas generales de BenchLM, LiveBench y Artificial Analysis.
¿Qué ranking de IA es más fiable?
Ninguno aislado. LiveBench resulta el más difícil de manipular, pues corrige respuestas objetivas con enunciados nuevos, aunque examina pocos modelos. Arena retrata mejor el gusto del público, si bien premia el estilo. Artificial Analysis ejecuta los tests por su cuenta y suma coste y rapidez. Lo aconsejable es combinar al menos dos.
¿Qué pasó con LMArena?
Se rebautizó. El 28 de enero de 2026, LMArena adoptó el nombre de Arena y se trasladó a arena.ai. Su denominación previa era Chatbot Arena, y el dominio viejo conduce al actual.
¿Hay algún ranking de modelos en español?
Arena incluye una categoría de español en su tabla de texto. El 13 de septiembre de 2026 reunía 160.421 votos, bastante para orientarse aunque con márgenes de error mucho más anchos que la general.
¿Por qué los rankings no coinciden?
Porque evalúan facetas diferentes: acierto en tests, gusto de los humanos o un promedio ponderado de numerosos ensayos. Cada web decide qué pruebas incluye y cómo resuelve los huecos de los modelos sin datos.
¿Me puedo fiar de los benchmarks que publican OpenAI, Google o Anthropic?
Como orientación, sí. Pero cada fabricante escoge los tests que muestra y las condiciones en que los pasa, así que conviene aguardar la confirmación de fuentes independientes como Artificial Analysis, LiveBench o Arena.
¿Cada cuánto cambia el primer puesto?
Con cada estreno relevante, y en 2026 los grandes laboratorios sacan modelos nuevos con mucha frecuencia. Por eso resulta más útil mirar qué modelos coinciden arriba en varias webs que preguntar quién ocupa el número uno esta semana.
Fuentes